2025年12月に行われましたコミックマーケット107にて、サークル参加してまいりました。
弊スペースに来てくださった方、本書を手に取っていただいた方、温かい感想をくださった方、改めて誠にありがとうございました。
おかげさまで会場では完売となりましたが、通販・電子版も承っておりますのでよろしくお願いします!
- 通販:メロンブックス(紙)
- 電子版:メロンブックス(電子)
頒布告知はこちらのツイートに掲載しています。
本書ではソフトウェア開発入門を扱いました。
そして、本ブログでは関連するトピックとしてCI/CDワークフローやブランチ戦略などを切り口に、制作過程についてまとめました。次回サークル参加を考えている方の参考になれば幸いです。
帰宅後…
ヒマリ「先生、冬コミお疲れ様でした」
先生「お疲れ様。無事に頒布できてよかったね」
ヒマリ「ふふっ、当然の結果ですね。あらゆる分野に精通する私と先生が力を合わせたのですから。大成功は当然の結果ですよ」
先生「ヒマリが色々と準備してくれたもんね」
ヒマリ「せっかくですから、本書がどのように作られたか、その裏側をお話ししましょう。私たちと同じく同人誌を作ろうとしている方の参考になるように、ノウハウを共有するのも上級生としての務めですから」
先生「そういえば、この本ってどうやって作ったの?Microsoft WordとかGoogle Docsじゃないんだよね?」
ヒマリ「ええ。本書は「Re:VIEW」という組版システムと、GitHub を組み合わせて制作しました。技術系の同人誌を書くなら、この組み合わせが非常に便利なのです」
組版システムRe:VIEWとは
Re:VIEWは、技術書の執筆に特化した組版システムです。マークアップ記法でテキストファイルを書き、PDF や EPUB などに変換できます。PDF 生成時には内部で LaTeX を使用しており、美しい組版が可能です。当初はLaTeXをそのまま使おうと考えておりましたが、導入の簡単さからRe:VIEW(環境構築にはRe:VIEW Starter)を使いました。
また、技術書ではコードブロックや特殊な記法を多用しますが、Re:VIEW はそういった表現に最適化されています。ただ単に原稿をテキストデータで作成したいだけならMarkdownを使うことも考えられますが、画像やコードブロックを挿入するならこういったシステムを使ったほうが便利です。
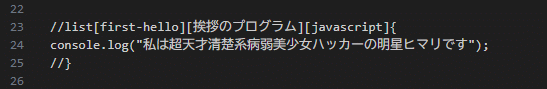
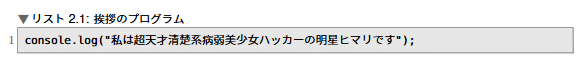
ヒマリ「そう、私のような美しさを兼ね備える原稿をラクに作るため、というわけです」
先生「なるほど。他のソフトウェアだと、それぞれデザインを設定しないといけないから大変だもんね」
GitHubで原稿データを管理するメリット
先生「さっきGitHubも使ったと言っていたよね。これってコードを管理するためのサービスじゃないの?」
ヒマリ「まさしく、そのコードを管理するための機能が原稿データの作成にも役に立つというわけです」
1. GitHub Actionsを用いて自動校正ができる
GitHub Actionsにワークフローを構築することによって、自動的にスペルチェックや文章校正が実行されるようにしました。今回導入したものは、TextLint(日本語校正)とCSpell(英単語スペルチェック)の2つです。
特に、TextLint(日本語校正)では以下のようなチェックを行っていました。
- 文の最大文字数が150文字以内であるか
- 表記揺れが生じていないか(”Web”と”ウェブ”など)
- 漢字が連続出現していないか
# ワークフローファイルを一部抜粋
# Node.js環境にTextlintやCSpellをインストールし、実行しています

- name: Setup Node.js
  uses: actions/setup-node@v4
  with:
      node-version: "20"

- name: Install textlint
  run: |
      npm install -g textlint
      npm install -g textlint-rule-preset-ja-technical-writing
      npm install -g textlint-rule-preset-ja-spacing
      npm install -g textlint-rule-prh
- name: Run textlint
  run: textlint "contents/**/*.re" "*.md" --no-color

- name: Install CSpell
  run: npm install -g cspell
- name: Run CSpell
  run: cspell "**/*.{re,md,yml,yaml,rb,py,css,html,js}" --no-progress
先生「こうすることで文章の読みやすさを維持するようにしていたんだね」
ヒマリ「…ところが、この漢字の連続出現を検知するルールが私の自己紹介に警告を出してくるのです。”超天才清楚系病弱美少女”が長すぎる、と」
そのときの様子はこちらのツイートに残しています。
ヒマリ「失礼な話ですよ。これは私という存在を的確に表現するために必要不可欠な言葉なのです。仕方がないので許可リストに登録しました」
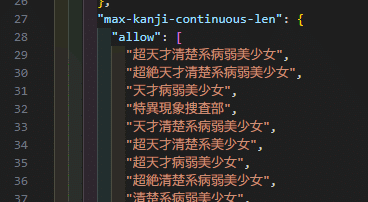
先生「…これって、校正(誤字脱字のチェック)であって校閲(内容のチェック)ではないんだね」
ヒマリ「そうですね。GitHub Copilotなどを活用すれば校閲も自動化できるのですが、あまり的確なレビューを得られなかったため積極的な採用はしませんでした。まあ、森羅万象を知り尽くしたこの私が校閲を担えば十分ですからね」
2. ブランチを分けることによってステータスを管理できる
ブランチを以下のように分けることで、原稿のステータス(校閲・推敲済みかどうか)を表現するようにしました。
- 「wip」ブランチ(書きかけの原稿)
- 「main」ブランチ(一旦完成の原稿)
- 「reviewed」ブランチ(レビュー済み原稿)
wipブランチで原稿データを執筆し、「wip → main」「main → reviewed」とプルリクエストを作成し、問題がなければマージしていくことによって原稿をレビューする段階を設けるようにしました。
ヒマリ「これは、ソフトウェア開発の現場でも広く導入されている”Git Flow”というブランチ戦略を真似たものです。レビューされていない原稿が印刷データに混入しないように、ということです」
先生「だからこそ、この方式ではmainブランチ・reviewedブランチに直接アップロード(Push)するのは禁止だったんだよね?」
ヒマリ「その通り!その対策として以下のような設定をVSCode(テキストエディタ)にしていましたね」
// .vscode/settings.json
{
    "git.branchProtection": [
        "main",
        "reviewed"
    ]
}
3. 原稿データを紛失するリスクが下がる
GitHubはクラウドサービスのため、アップロード(Push)するとインターネット上のサーバーに同じものが保存されます。今回はGitHubとOneDriveの併用でデータのバックアップを行っていました。
ヒマリ「大事なデータですから、用心に越したことはありませんね」
まとめ
新刊「明星ヒマリと学ぶソフトウェア開発入門」は、このようにして原稿データの管理を行っておりました。
今回ご紹介したCI/CDワークフローは原稿データ(文章)の品質管理を目的としておりましたが、実際のソフトウェア開発でもコードの品質管理のために同様の仕組みが活用されています。(リンターやテストなど)
これらはソフトウェアの安全性や開発生産性に直結するため、重視されているということです。
本書では扱えなかった内容、お楽しみいただけましたら嬉しいです。
コミケ全体での振り返り
2日間お疲れ様でした。
締め切り前から当日終わるまで、本当に大変でしたが楽しく取り組めたと思います。細々とした振り返りはこちらのツイートにぶら下げています。
そして、
コミケ50周年おめでとうございます!
次回もまた参加します!